La eterna búsqueda del motor de búsqueda
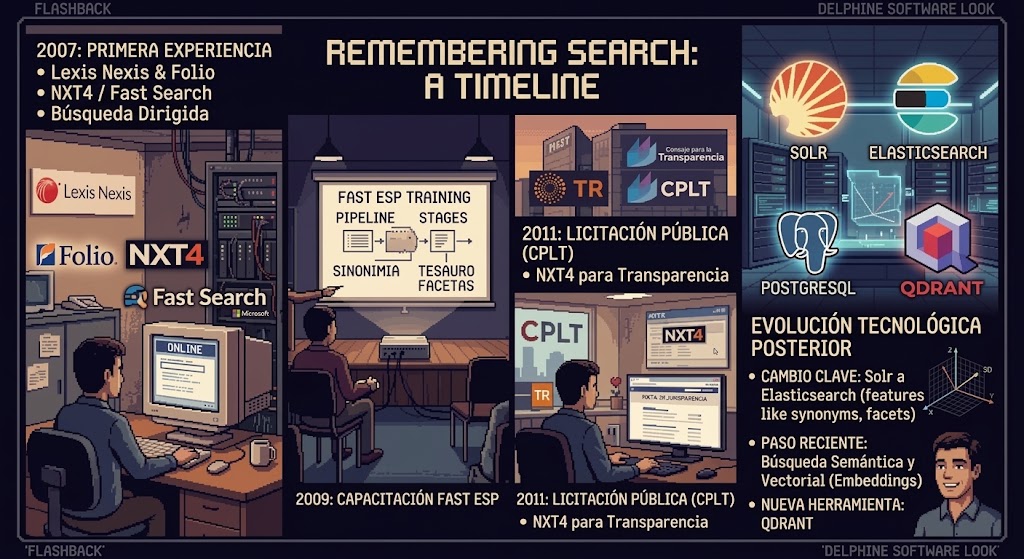
Mi primera experiencia con un indexador y motor de búsqueda se remonta al año 2007, cuando lanzamos el “Online” en Lexis Nexis. Por aquel entonces usábamos Folio y NXT4, de la empresa Fast Search, que luego fue adquirida por Microsoft. Era una herramienta formidable: búsqueda dirigida sobre texto marcado, comodines, búsqueda en contexto, proximidad de términos…
Luego, en el año 2009, me enviaron a una capacitación en el nuevo Fast ESP. Fue un gran salto en ese momento: pipeline de stages, sinonimia, tesauro, facetas, y un largo etcétera.
En 2011, ya en TR, ganamos la licitación para realizar el portal de jurisprudencia del Consejo para la Transparencia. Fueron más de 10 años trabajando con esta institución, con gente a la que le tuve gran cariño y admiración. Enfrentamos esa tarea con el viejo NXT4, que estuvo a la altura de la situación.
La siguiente licitación trajo un cambio realmente importante: Solr y Elasticsearch. Herramientas increíbles: protowords, stopwords, sinónimos, facetas, contexto, una API potente, indexación bajo demanda y snapshots. Fue un excelente trabajo que me llenó de orgullo. Posteriormente, pasamos de lleno a las búsquedas semánticas, lenguaje natural y bases vectoriales. Desde hace ya un par de años he estado trabajando en generar embeddings y probar las nuevas capacidades de Solr y PostgreSQL. PgVector me parece que se convertirá en una gran opción para bases masivas: tener el origen de datos y la base vectorial juntos es muy atractivo.
También estuve trabajando con Qdrant, una herramienta nueva que me parece muy interesante. Tiene una API extensa y muy bien documentada.
Le tengo un cariño especial a Solr, que desde hace un par de versiones ha implementado búsqueda vectorial. Espero tener pronto la oportunidad de probarlo.